


Конвейер и потоки
Если вы дочитали до этого места, то самое время рассказать вам самую важную вещь про оболочку — важна не столько функция запуска других программ, сколько управление данными.
В Linux есть две схожие концепции — конвейеры (pipes) и потоки (streams). Они решают разные задачи и работают на разных уровнях (абстракции).
Что такое stream?
Потоки — абстракции, используемые процессами для работы с вводом/выводом (I/O), и представляют собой потоки данных между программой и окружением или между частями программ.
Потоки не хранят данные, это концептуальное понятие!
В системе есть три стандартных потока:
stdin(дескриптор 0) — стандартный ввод, данные «идут в»;stdout(1) — стандартный вывод, данные «идут из» (буферизуется);stderr(2) — стандартный вывод ошибок, данные «идут из» (небуферизован).
Несмотря на то, что потоки не хранят данные сами по себе, стоит помнить, что stdout буферизируется, а stderr — нет. Это происходит на уровне библиотеки libc (или какой‑то другой, отвечающей за runtime). Скомпилируйте и запустите вот такую программу:
#include <stdio.h>
#include <unistd.h>

int main() {
  printf("Hello, stdout!");
  fprintf(stderr, "Hello, stderr!");
  sleep(5);
  return 0;
}
Несмотря на то, что Hello, stdout! мы напечатали раньше, чем Hello, stderr!, сначала мы увидим вывод в поток ошибок, и только затем — в поток стандартного вывода.
$ gcc main.c -o main
$ ./main
Hello, stderr!Hello, stdout!
Все данные, которые «записывают» в поток, сохраняются в буфер перед тем, как будут отправлены в точку приёма (например, терминал). Буфер уменьшает количество операций ввода/вывода, что положительно сказывается на производительности. Обычно буфер составляет 64 КБ — мы об этом уже говорили ранее. Буферизация обычно происходит до символа перевода строки \n. Добавьте его в конец строки в `printf` и посмотрите, как изменится вывод.
Стандартный поток ошибок отличается от стандартного вывода, так как отправляет данные напрямую, в обход буфера. Сделано это по той причине, что ошибки имеют более высокий приоритет — при падении программы всё, что осталось в буфере, будет потеряно, а нам, понятное дело, хотелось бы видеть по какой причине программа упала.
Управление буфером осуществляется через утилиту stdbuf или через setvbuf() в Си. Вы можете отключить буферизацию для стандартного потока вот так:
$ stdbuf -o0 ./main
Hello, stdout!Hello, stderr!
В Linux есть файлы /dev/stdin, /dev/stdout и /dev/stderr, которые представляют упомянутые выше потоки. Они созданы для унификации интерфейса. Каждая программа может ссылаться на них и работать как со своим стандартным вводом и выводом. Однако, нужно понимать, что для каждой программы ввод и вывод независимый. Данные файлы ничто иное как динамические символьные ссылки. Реализуется это через систему VFS (Virtual Filesystem) в ядре. Если /dev/stdin предназначен для терминала, то он будет указывать на /proc/self/fd/0. Здесь /proc/self/ — ещё одна символьная ссылка, которая понятна только текущему процессу. Операционная система находит PID и заменяет путь на /proc/[PID]/fd/0.
$ file /dev/stdin
/dev/stdin: symbolic link to /proc/self/fd/0
$ file /proc/self/fd/0
/proc/self/fd/0: symbolic link to /dev/pts/0
$ file /dev/pts/0
/dev/pts/0: character special (136/0)
Теперь о самом интересном — вы можете перенаправлять потоки! Ранее мы уже привели пример, но не объяснили, что это было:
$ echo "Heinrich Hertz" > message.txt
$ cat message.txt
Heinrich Hertz
Всё, что может делать команда echo, — отправлять какой‑нибудь текст в стандартный вывод. Символом > мы перенаправили стандартный вывод в файл.
Если вы читали внимательно, то наверное помните, что в Linux всё есть файл. С ножками популярного нынче одноплатного компьютера Raspberry Pi, при наличии соответствующего Device Tree, можно работать через
bash:$ echo "out" > /sys/class/gpio/gpio9/direction $ echo "1" > /sys/class/gpio/gpio9/valueЧерез
echoмы сначала настроили GPIO 9 как выход, а затем установили высокий логический уровень на ней. На некоторых ноутбуках так можно управлять, например, светодиодной подсветкой клавиатуры.
Команда echo не умеет читать из stdin, поэтому такая команда не сработает:
$ echo < message.txtОднако можно сделать так:
$ echo "$(<message.txt )"Другие программы могут принимать стандартный ввод:
$ ls < echo "-la"Команда ls может возвращать не только в стандартный вывод, но и в стандартный поток ошибок. Да, для терминала это не имеет значения:
$ ls /root
ls: cannot open directory '/root': Permission denied
Но для перенаправления потоков — имеет!
$ ls /root > root.txt
ls: cannot open directory '/root': Permission denied
$ cat root.txt
Можно увидеть, что, во‑первых, по какой‑то причине ls всё так же распечатал ошибку, а внутри файла, в который мы перенаправили поток, ничего нет. Дело в том, что > перенаправляет стандартный вывод, но не стандартный вывод ошибки. Чтобы перенаправить stderr, нужно указать дескриптор напрямую:
$ ls /root 2> root.txt
$ cat root.txt
ls: cannot open directory '/root': Permission denied
Перенаправить сразу два потока в файл используя конструкцию &>:
$ ls /root ~ &> root.txt
cat root.txt
/home/oliver:
# ...
ls: cannot open directory '/root': Permission denied
Перенаправить потоки в разные файлы:
$ ls /root ~ > stdout.txt 2> stderr.txt
$ cat stderr.txt
ls: cannot open directory '/root': Permission denied
$ cat stdout.txt
/home/oliver:
# ...
Перенаправить стандартный поток ошибок в стандартный вывод (обозначается как &1):
$ ls /root > out.txt 2>&1
$ cat out.txt
ls: cannot open directory '/root': Permission denied
Порядок имеет значение. Выполните команду и объясните поведение:
$ ls /root 2>&1 > out.txtПри каждом вызове > содержание файла в нём будет только то, что было в текущем выводе. Если вы хотите добавить что-то в конец файла, то используйте конструкцию >>:
$ echo "Heinrich" > name.txt
$ echo "Hertz" >> name.txt
$ cat name.txt
Heinrich
Hertz
Так же, как и с одинарным знаком вы можете указывать дескриптор напрямую:
$ ls /root 2>> name.txt
$ cat name.txt
Heinrich
Hertz
ls: cannot open directory '/root': Permission denied
Можно создать собственный поток и работать с ним (дескриптор должен быть больше 2). Это полезно когда нужно разделять уровни логирования.
exec 3> custom_output.txt
echo "Custom stream output" >&3
exec 3>&-
Вспомним, однако, одну из команд, которую мы использовали ранее:
nohup python3 -m http.server 8000 --bind 0.0.0.0 > /dev/null 2>&1 &Во‑первых, теперь становится понятно, что 2>&1 перенаправляет поток ошибок в стандартный поток, а он уходит в /dev/null.
Специальный файл /dev/null используется как чёрная дыра, data sink. Всё, что туда отправляется, исчезает и больше не доступно. Если вам нужно игнорировать вывод программы — отправьте его в /dev/null.
$ echo "Best book ever!" > /dev/null 2>&1Если нас интересует только код возврата, `/dev/null` поможет заглушить вывод:
$ ls ~ > /dev/null && echo "Success"
Success
$ ls /root > /dev/null && "Success"
Точно так же можно игнорировать ввод:
some < /dev/nullЗабавный побочный эффект, создание пустого файла:
cat /dev/null > void.logКроме чёрной дыры, в Linux есть источник энтропии (строго говоря он не является самим источником) — /dev/urandom (unlimited random). С его помощью можно создавать случайные последовательности. В примере ниже мы создаём случайный ключ шифрования длиной 16 байт и сохраняем его как бинарный файл:
$ head -c 16 /dev/urandom > random_key.bin
$ xxd random_key.bin
00000000: 3d2c cd55 10c5 fa85 748e aeba fbde 6200 =,.U....t.....b.Вbashвстроена специальная переменная, которая никак не связана сurandom/random—RANDOM. Если выводить её значение, то она будет возвращать число от 0 до 32767.
Нужен сложный пароль? Легко:
$ tr -dc 'A-Za-z0-9!@#$%^&*_' < /dev/urandom | head -c 12 | xargs
ZbEuJ^!vSuOL
Здесь, однако, нужно кое-что помнить. Данный файл — не блокирующий источник энтропии, в отличие от /dev/random, т. е. он всегда вернёт что-нибудь, даже если поток энтропии в системе сейчас низок.
Пример довольно синтетический, содержание файла можно вывести и через cat, но давайте посмотрим на команду вида:
echo $( 0< chsm/README.md )Конструкция 0< перенаправляет содержимое файла в stdin, а $( ... ) выполняет команду во вложенной оболочке и подменяет себя выводом выполненной команды. Таким образом аргументом echo становится содержимое файла README.md.
Это очень полезное свойство — вы можете предобработать данные одной утилитой и скормить её другой. Например утилита colordiff принимает на вход два файла. Если в случае с текстовыми файлами проблем никаких нет, то вот сравнивать бинарные — проблема; при вводе в стандартный вывод все байты будут заменяться на символы, в том числе непечатные. Разобраться в этой каше будет невозможно. Преобразуем файл в шестнадцатеричный вид и скормим обычный текст в diff:
$ head -c 16 /dev/urandom > left.bin
$ cp left.bin right.bin
$ head -c 16 /dev/urandom >> left.bin
$ head -c 16 /dev/urandom >> right.bin
$ colordiff -y <(xxd -c 8 left.bin) <(xxd -c 8 right.bin)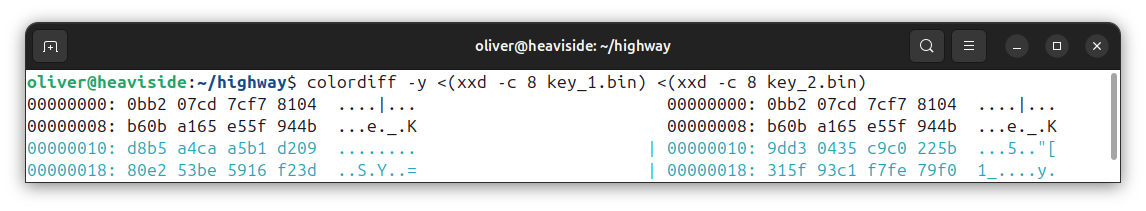
При написании скриптов иногда нужно получить настоящий ввод от пользователя. Для этого можно использовать утилиту read (чтение с клавиатуры будет продолжаться пока вы не нажмёте Enter):
$ read
highway to shell
По умолчанию утилита сохраняет результат в переменную REPLY:
$ echo ${REPLY}
highway to shell
Либо укажите собственную переменную:
$ read VALUE
highway to shell
$ echo ${VALUE}
highway to shell
Перенаправить содержимое файла в read:
$ read < title.txtОднако провернуть такой же трюк с echo уже не получится, потому что < перенаправляет только содержимое файла. Сделать это можно только через конструкцию <<< (here string):
$ read <<< echo "highway to shell"
# or without echo at all:
$ read <<< "highway to shell"
Ещё один пример направления строки в команду:
$ base64 <<< "highway to shell"
aGlnaHdheSB0byBzaGVsbAo=
here string — упрощённая версия here‑document. Можно подать несколько строк в команду через структуру <<EOF. Вместо EOF допустимо использовать другую последовательность, например END или DONE. Если вы обернёте EOF в одиночные кавычки ('EOF'), то переменные не будут раскрываться, а команды не будут выполняться. В случае использования двойных кавычек ("EOF") переменные будут раскрываться, но не будут выполняться команды.
$ pushups="10"
$ cat <<EOF > diary.log
On $(date +%A)
I did $pushups pushups
EOF
$ cat diary.log
On Friday
I did 10 pushups
Либо через подмену команды:
read var < <(echo "telegraph")Потоки могут быть прикреплены к файлам, устройствам, конвейерам (pipes) или даже к сетевым сокетам. Когда вы печатаете текст через printf в Си, то данные по умолчанию идут именно в стандартный вывод через системные вызовы внутри библиотеки libc.
Перенаправить поток прямо из кода в нужный поток можно с помощью функции dup2.
## Что такое конвейер?
Конвейеры используются для межпроцессного взаимодействия (IPC, inter-process communication). Они работают по принципу FIFO (First In First Out). В отличие от обычных файлов, данные записанные в FIFO читаются последовательно другим процессом и как только это происходит, эти данные больше недоступны. Другими словами, конвейеры — это однонаправленные потоки данных.
Можно выделить три типа конвейеров.
- Безымянный конвейер — создаётся в памяти и обычно используется для общения между родительским и дочерним процессами. В языке Си за это отвечает функция
pipe(). - Именованные потоки — существуют как файлы в файловой системе и используются для несвязанных друг с другом процессов.
- Конвейеры оболочки (
|) — также являются безымянными потоками, но создаются в самой оболочке для передачи вывода одной программы на вход другой.
Теперь, как и с любым другим конвейером, мы можем отправить туда данные:
# Create a named pipe
$ mkfifo -m 600 ~/pump_my_pipe
# Redirect data there
$ echo "We need more screens" > ~/pump_my_pipe
Пока данные не будут считаны другим процессом, ваш терминал будет заблокирован! Откройте другой терминал и считайте данные:
$ cat < ~/pump_my_pipe
We need more screens
Именованный конвейер имеет буфер ограниченного размера.
$ cat /proc/sys/fs/pipe-max-size
1048576
Если переполнить буфер, то приём данных будет остановлен, пока другой процесс не прочитает (тем самым удалив) хотя бы часть данных. Если буфер пуст, но из него будут пытаться читать, то это заблокирует процесс считывания, пока кто-нибудь не поместит туда данные.
Избавиться от конвейера можно как от обычного файла командой rm. Почему? Потому что всё есть файл!
Используя командуls, можно также узнать, является ли файл конвейером: первая буква будетp.
И, наконец, самое интересное — безымянные конвейеры в оболочке — передача данных одной программы другой. Допустим, вы время от времени пополняли список продуктов к покупке. Вы делали это в течение недели и, увы, иногда добавляли одно и то же.
$ cat data/grocery.txt
Newton's Apples
Thermodynamic Ice Cream
Archimedes' Oranges
Schrödinger's Watermelon
Planck's Pickles
Doppler Bananas
Friction-Free Butter
Thermodynamic Ice Cream
Doppler Bananas
Сейчас же вы решили пойти в магазин, к счастью, на вашем телефоне стоит PostmarketOS и файл уже лежит у вас на телефоне (люди разные бывают). Как быстро получить список уникальных позиций к покупке? Мы уже знакомы с утилитами сортировки и нахождения уникальных записей. Объединением их!
$ cat data/grocery.txt | sort | uniq
Archimedes' Oranges
Doppler Bananas
Friction-Free Butter
Newton's Apples
Planck's Pickles
Schrödinger's Watermelon
Thermodynamic Ice Cream
Через | вы направили вывод утилиты cat на вход sort, а её вывод на вход uniq. Не правда ли, это быстрее и удобнее, чем писать утилиту на python? Здесь вам понадобились только стандартные утилиты, которые вы найдёте фактически на любом Linux‑дистрибутиве!
Когда требуется направить вывод в несколько мест используйте утилиту tee. Она во-первых позволит так же распечатать вывод, а во-вторых позволит сохранить в один или несколько файлов эти данные.
$ cat data/grocery.txt | sort | uniq | tee final.txt
apples
eggs
meat
oranges
$ ls -la final.txt
-rw-rw-r-- 1 oliver oliver 140 Aug 30 06:31 final.txt
Ещё пример, получим список всех пользователей в системе. Имена пользователей находятся во второй колонке файла /etc/passwd. Колонки разделены символом :. Вместо того, чтобы писать программу и пытаться её отлаживать, проще сделать так:
$ cat /etc/passwd | cut -d ":" -f 1 | sortУтилиты могут понимать, откуда идёт вход, из файла или из `stdin`. Так, например, вывод одной и той же программы будет отличаться:
$ ls -la > files.txt
$ wc -l files.txt
46 files.txt
$ ls -la | wc -l
46
Используя конвейеры и такие утилиты, как grep можно быстро находить именно то, что вам нужно, а не разгребать огромные текстовые файлы/выводы вручную.
$ ip a | grep -oE "\b([0-9]{1,3}\.){3}[0-9]{1,3}\b"
127.0.0.1
192.168.1.105
192.168.1.255
Ранее мы уже упоминали dmesg. Искать там руками — очень долго. Подключите устройство к USB и выполните:
$ dmesg -T | tail -n 200 | grep -iE '(tty(USB|ACM))'
[ +0.000417] usb 1-4: FTDI USB Serial Device converter now attached to ttyUSB0
В случае, когда выполнение команды занимает значительное время, для визуализации процесса можно использовать утилиту pv (Pipe Viewer) — она визуализирует прохождение данных через конвейер:
$ tar -cf - ~ | pv | gzip > home.tar.gz
tar: Removing leading `/' from member names
65MiB 0:00:12 [33.8MiB/s] [ <=> ]
Вы даже можете выкачать целую папку через ssh в виде архива:
ssh user@server 'cd ~ && tar -cf - proj | gzip -9' >proj.tgzИли наоборот, сжимая, скопировать на удалённый сервер и распаковав на месте:
tar -c --zstd ~/proj | ssh user@server "cd ~ && tar -x --zstd"Для больших файлов лучше использовать rsync.
Отдельный файл можно отправить так:
$ cat file | pv | ssh user@server "cat > file"
